Transformer 前置知识 02:矩阵乘法
上一课讲了点积:两个向量对应位置相乘再相加,结果越大,两个向量越像。
可一句话里有很多词,每两个词都要算一次点积。5 个词就要算 25 次,1000 个词就是 100 万次。一个个算显然太慢了,需要一种能”一次全部算完”的方法——这就是矩阵乘法。
什么是矩阵
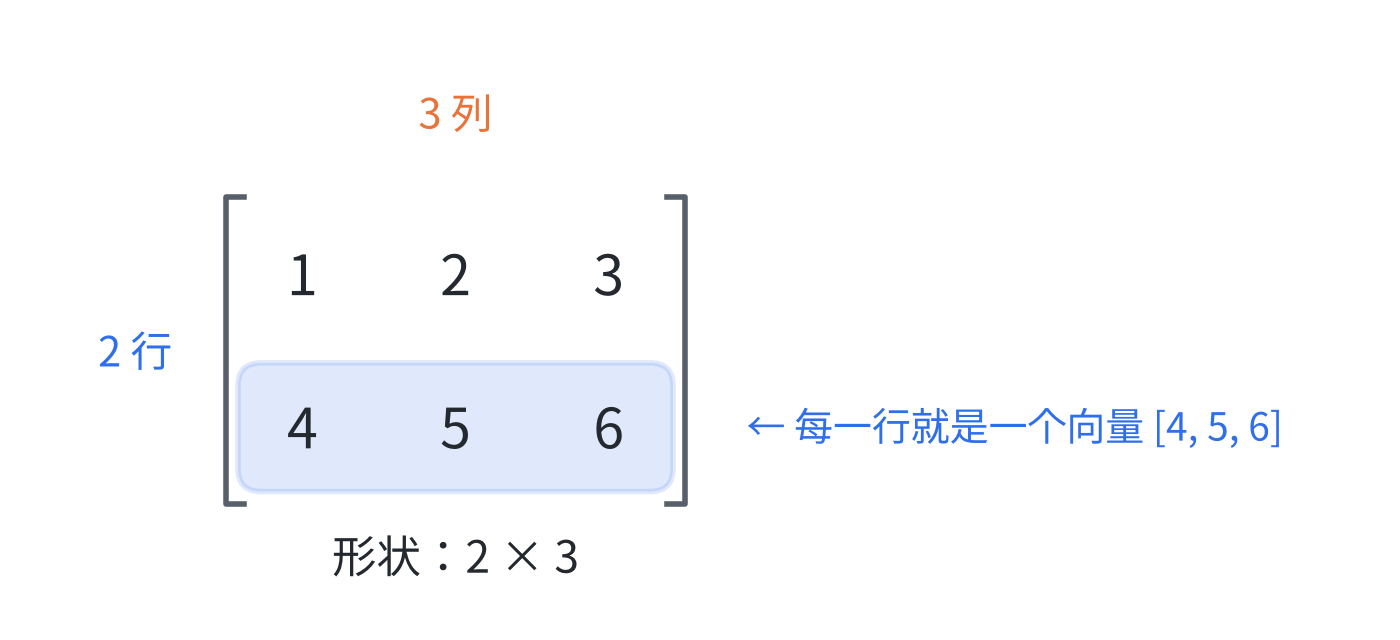
矩阵就是把数字排成一个长方形的表格。比如:
它有 2 行、3 列,我们说它的形状是 2 × 3(先说行数,再说列数)。
换个角度看,矩阵也可以理解成一摞向量:每一行就是一个向量。上面这个矩阵,就是向量
一句话就是一个矩阵
在 Transformer 里,每个词先被变成一个向量。把一句话里所有词的向量一行一行叠起来,就得到一个矩阵。
比如”我爱猫”三个词,每个词用一个 4 维向量表示:
| 词 | 向量 |
|---|---|
| 我 | |
| 爱 | |
| 猫 |
叠起来就是一个 3 × 4 的矩阵:3 个词,每个词 4 维。
真实模型里,这个矩阵可能是几千个词 × 几千维,但道理完全一样。
矩阵乘法的规则
两个矩阵相乘,规则只有一句话:
结果的第 i 行第 j 列,等于左边矩阵的第 i 行,和右边矩阵的第 j 列做点积。
来算一个例子:
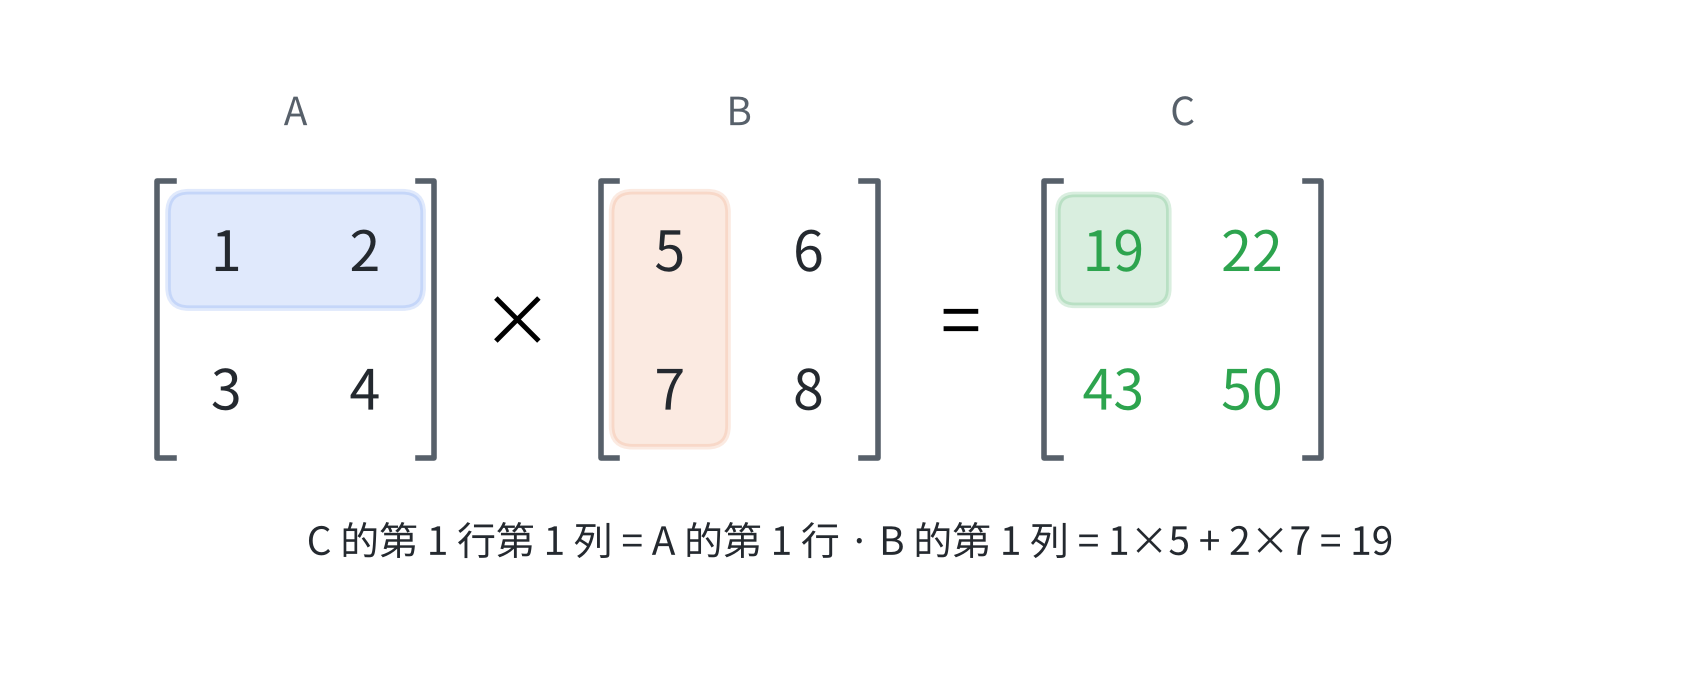
逐格来算:
| 结果位置 | 左边的行 · 右边的列 | 计算 | 结果 |
|---|---|---|---|
| 第 1 行第 1 列 | 19 | ||
| 第 1 行第 2 列 | 22 | ||
| 第 2 行第 1 列 | 43 | ||
| 第 2 行第 2 列 | 50 |
所以,矩阵乘法本质上就是一大批点积:左边的每一行,和右边的每一列,两两做点积。
用代码验证一下:
1 | import numpy as np |
形状规则
矩阵相乘对形状有一个要求:左边的列数,必须等于右边的行数。原因很简单,点积要求两个向量一样长,左边一行的长度是它的列数,右边一列的长度是它的行数。
中间的
例如
转置
还有一个经常配合使用的小工具:转置。它把矩阵沿着对角线翻过来,行变成列,列变成行,写法是在右上角加一个
形状从 2 × 3 变成了 3 × 2。
回到 Transformer:
现在可以看懂注意力公式里最核心的一步了。
Transformer 会给每个词算出两个向量:Q(查询)和 K(键)。把所有词的 Q 向量叠成矩阵
的形状是 的形状是 - 结果的形状是
根据矩阵乘法的规则,结果的第 i 行第 j 列,正好是第 i 个词的 Q 和第 j 个词的 K 的点积,也就是”第 i 个词该多关注第 j 个词”的分数。
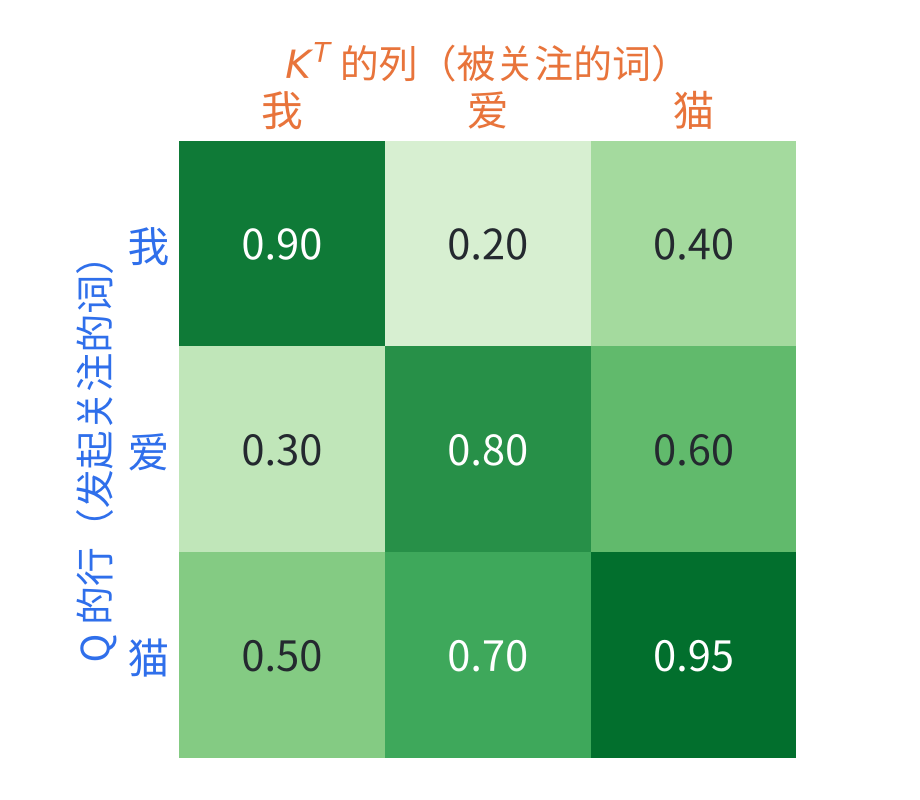
一次矩阵乘法,就把所有词两两之间的分数全部算了出来。
为什么要用矩阵乘法
既然本质都是点积,为什么不一个个算?因为 GPU 特别擅长矩阵乘法:成千上万次乘法可以同时进行,比一个个算快几个数量级。训练大模型时,绝大部分计算量都花在矩阵乘法上。
小结
- 矩阵是数字排成的表格,也可以看成一摞向量
- 矩阵乘法:结果的第 i 行第 j 列 = 左边第 i 行 · 右边第 j 列,本质是一大批点积
- 形状规则:
- 转置:行变列、列变行,记作
- 注意力里的
,就是用一次矩阵乘法,算出所有词之间的分数
下一课讲导数与梯度下降:模型是怎么一点点学会的。